Treinar modelos de inteligência artificial em várias GPUs exige mais do que capacidade de processamento. Os recursos precisam estar disponíveis no momento certo, os processos devem formar um grupo capaz de executar a tarefa e a comunicação entre eles precisa acompanhar o ritmo do treinamento.
Para as equipes que operam Kubernetes, isso coloca duas decisões no centro da arquitetura: quando admitir um trabalho e onde posicionar seus componentes. Uma infraestrutura ocupada pode entregar menos progresso do que o esperado quando parte dos recursos espera pelos demais ou passa tempo demais trocando dados.
A notícia que motivou este artigo foi publicada no blog da CNCF em 12 de novembro de 2026. David Lentz, da Datadog, apresenta uma abordagem que combina Kueue, posicionamento orientado à topologia e o plugin Coscheduling. A seguir, explicamos os conceitos e os cuidados para avaliar essa estratégia.
Por que disponibilizar GPUs não basta
Em um treinamento distribuído, diferentes processos participam do mesmo trabalho. Durante a execução, eles precisam compartilhar informações, como os dados usados para atualizar o modelo. O desempenho depende tanto da computação quanto dessa troca.
Imagine um trabalho que precisa de quatro participantes. Se apenas dois encontram recursos e os demais continuam pendentes, a parte alocada pode ficar esperando. Mesmo com o grupo completo, um caminho de comunicação inadequado pode prolongar cada etapa do treinamento. São problemas diferentes e precisam ser observados separadamente.
Kueue: organizar a entrada dos trabalhos
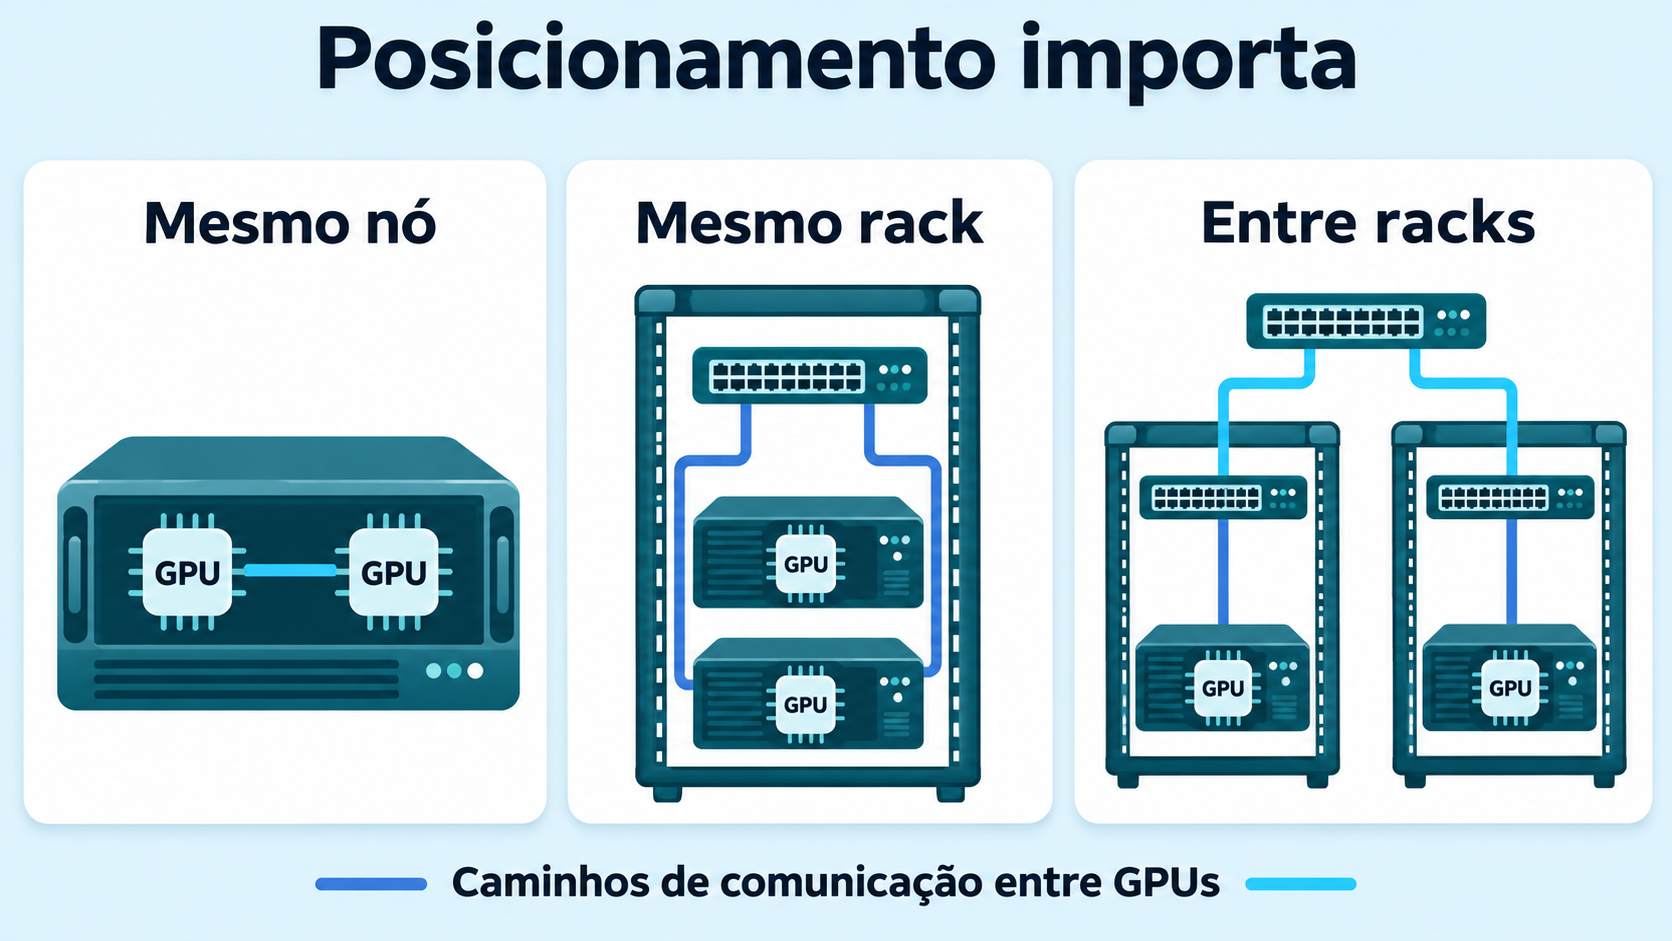
O Kueue gerencia filas, cotas e a admissão de trabalhos no Kubernetes. Ele considera as políticas configuradas para decidir se uma tarefa pode avançar ou deve continuar aguardando. Isso ajuda a distribuir recursos compartilhados entre equipes e prioridades.
Essa camada complementa o scheduler, responsável por associar pods aos nós. Uma tarefa que ainda aguarda admissão exige uma investigação diferente de outra já admitida, mas com pods pendentes. Entender essa separação reduz tentativas de corrigir o problema na camada errada.
Topologia: a localização influencia a comunicação
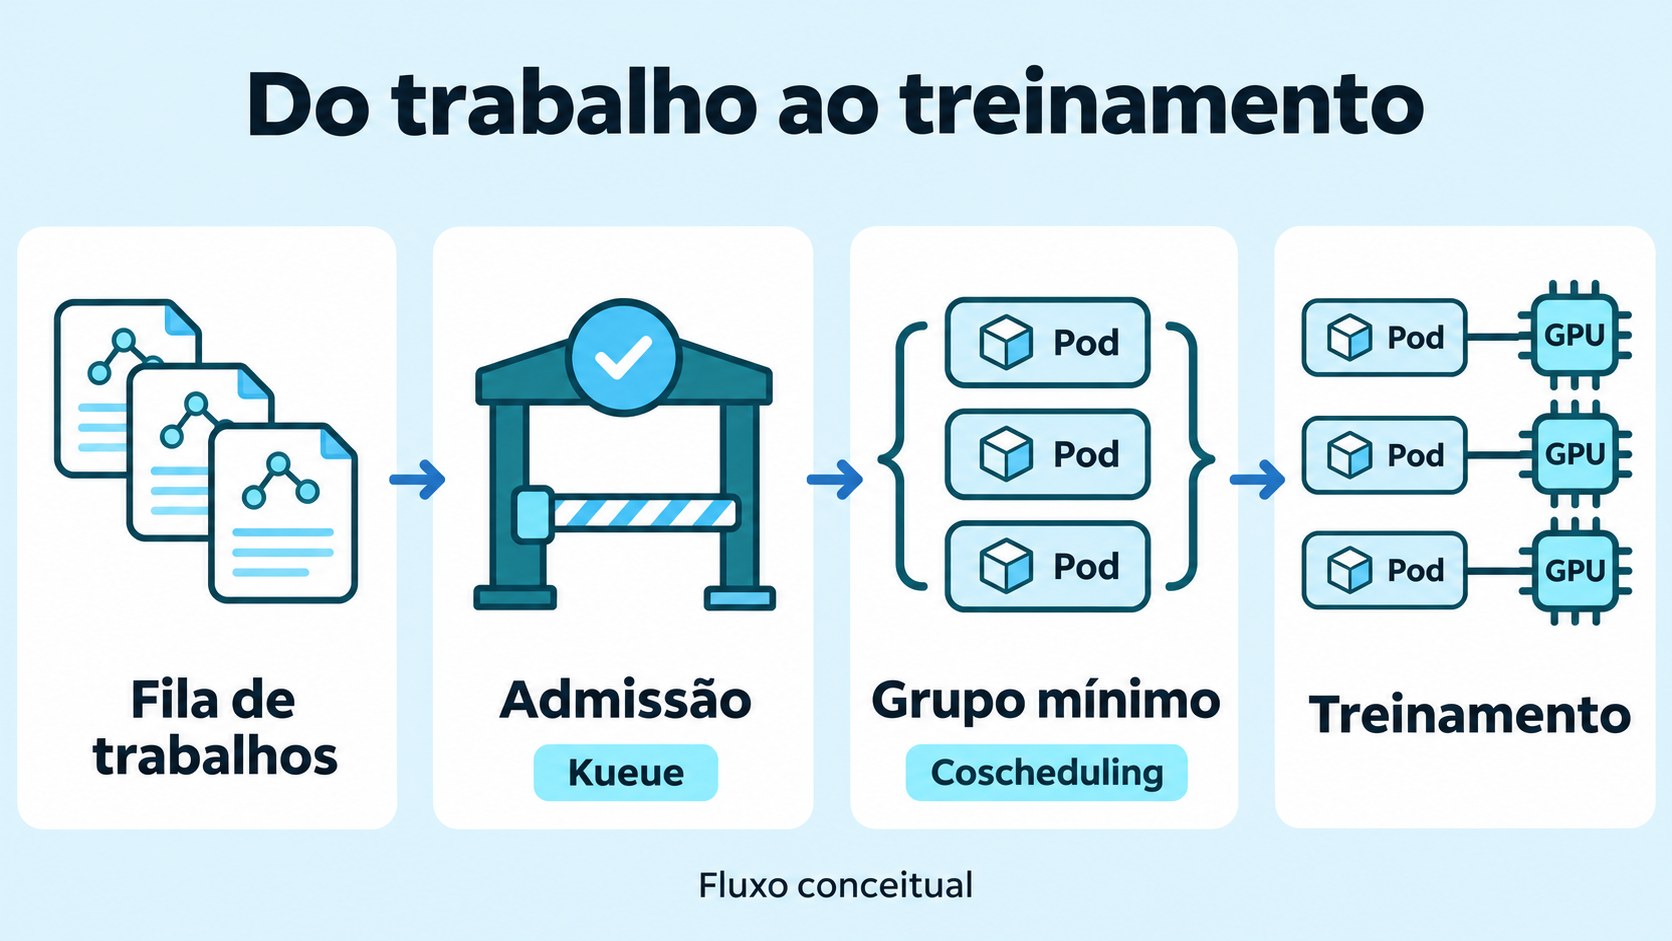
A topologia descreve como servidores, racks e conexões estão organizados. GPUs no mesmo servidor podem contar com interconexões locais de alta velocidade. Entre servidores, a rede passa a fazer parte do caminho. O efeito dessa distância depende do hardware, da rede e do padrão de comunicação do treinamento.
Com o Topology-Aware Scheduling (TAS), o Kueue utiliza etiquetas nos nós para considerar os domínios da infraestrutura. Essas informações precisam ser fornecidas pelo provedor ou pela administração do cluster. Etiquetas incompletas ou incorretas podem levar a decisões de posicionamento inadequadas.
A política pode exigir um domínio ou apenas dar preferência a ele. Uma restrição obrigatória oferece menos flexibilidade; uma preferência permite alternativas quando o agrupamento desejado não comporta o trabalho. Por isso, o possível benefício na comunicação deve ser avaliado junto com o tempo adicional de espera por capacidade.
Agendamento conjunto: formar o grupo necessário
O Coscheduling acrescenta coordenação ao agendamento. Ele utiliza o recurso PodGroup para identificar os participantes de um trabalho e definir o número mínimo necessário para o grupo avançar.
Esse mecanismo procura reduzir alocações parciais que não permitem executar a tarefa. Ele não garante que todos os contêineres comecem no mesmo instante: obtenção de imagens, condições dos nós e prontidão da aplicação continuam influenciando o início efetivo do treinamento.
A combinação com o Kueue é uma abordagem possível e precisa ser validada nas versões e integrações do ambiente. O próprio Kueue também oferece controles de espera pela prontidão dos pods, com timeout e retorno à fila. Esses controles de ciclo de vida têm uma função diferente da coordenação realizada no scheduler.
O que medir: da fila ao progresso do modelo
Uma avaliação útil conecta as decisões da plataforma ao resultado da aplicação. A utilização das GPUs, sozinha, não mostra se o treinamento está avançando no ritmo esperado. Acompanhe quatro pontos:
- Admissão: quantidade de trabalhos pendentes, motivos de bloqueio e tempo de espera na fila.
- Posicionamento: domínio atribuído ao trabalho e localização efetiva dos pods.
- Formação do grupo: participantes disponíveis, eventos dos pods e ocorrências de timeout.
- Produtividade: passos, amostras ou tokens processados por segundo, conforme o treinamento, junto com a telemetria de GPU e rede.
Se o trabalho não sai da fila, investigue cotas, capacidade e restrições. Se foi admitido, mas o grupo não se forma, examine as condições de agendamento e inicialização. Se o grupo executa e o progresso continua baixo, correlacione a aplicação com a comunicação e a saúde da infraestrutura.
Como começar com uma avaliação prática
Selecione um treinamento representativo e registre uma linha de base: configuração, tempo na fila, duração da execução e recursos consumidos. Depois, compare políticas de admissão e posicionamento em condições equivalentes. Inclua o ciclo completo do trabalho na análise.
O resultado depende da carga, das conexões disponíveis e das políticas do cluster. Não há um ganho universal a prometer. O objetivo é descobrir quais decisões tornam o uso das GPUs mais produtivo e previsível no seu ambiente.
Conheça a atuação da SSYS em Kubernetes e infraestrutura e automação para conectar arquitetura, operação e evolução da sua plataforma.
Referências e leitura complementar
- CNCF — David Lentz: Gang scheduling and topology-aware placement for AI training in Kubernetes, 12 de novembro de 2026.
- Kueue: visão geral, Topology-Aware Scheduling e espera pela prontidão dos pods.
- Kubernetes SIG Scheduling: documentação do plugin Coscheduling.